
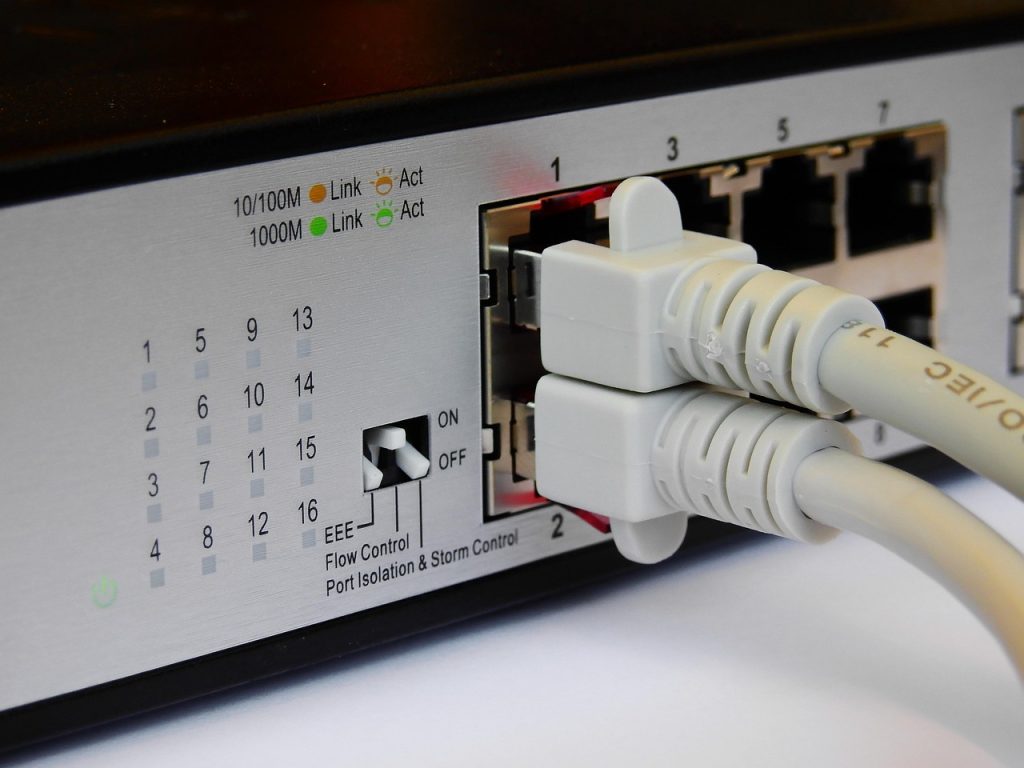
把 16 台 AI 服务器(如 DGX 类)组成本地集群跑大模型,瓶颈往往不在算力卡本身,而在节点间互联网络。
一、为什么高速互联是命门
分布式训练要在节点间频繁同步梯度,数据量巨大、对时延敏感。普通以太网吞吐与时延都跟不上,需用 RDMA:InfiniBand 或 RoCE(基于融合以太网的 RDMA),把节点间通信时延压到微秒级、带宽拉满,才能跑出 2.8T 级的聚合算力。
二、拓扑与分区
采用 spine-leaf(叶脊)拓扑,leaf 接服务器、spine 做无阻塞转发,横向扩展性好。业务网(训练同步)与存储网(数据集/检查点读写)分离,避免存储 IO 抢训练带宽;管理网独立,便于带外运维。每条链路按卡数与带宽配足,任何一条拥塞都会拖慢整体。
三、落地注意
网卡、交换机、线缆要匹配(如 200/400 G 规格一致);开启 PFC/ECN 保证无损以太(RoCE 场景);拓扑连接按”全互联对等”规划,确保任意两节点带宽均衡。网络是集群的”神经系统”,设计阶段就要和算力、存储一起算,别最后才补。
三、多机集群组网要点
- 分层 → 管理/存储/计算流量分平面,互不抢带宽。
- 上联 → 接入交换机端口绑定提吞吐,避免单口瓶颈。
- 实测 → 看集合通信带宽与 GPU 利用率,而非理论值。
多机训练瓶颈常在网络而非算力:NCCL 集合通信吃满上联就成短板。组完网先跑带宽基准,确认 GPU 利用率高而非在等数据,再上训练。
本文整理自公开技术文章,正文未做实质性改写,仅供技术参考。正文主体与原文基本一致,版权归原作者所有;本站仅作技术学习与方案参考,如涉侵权请联系本站删除。



评论 0
还没有评论,来抢沙发吧。